南湖新闻网讯(通讯员 訾伊晗 韦祎 秦令帅)10月8日晚,2026年迎新季“青年学者面对面”系列活动(第四期)在大学生活动中心报告厅举行。经济管理学院池韵佳教授以“生成式人工智能:聪明背后的偏见”为题,与同学们共话算法偏见与数字公平。
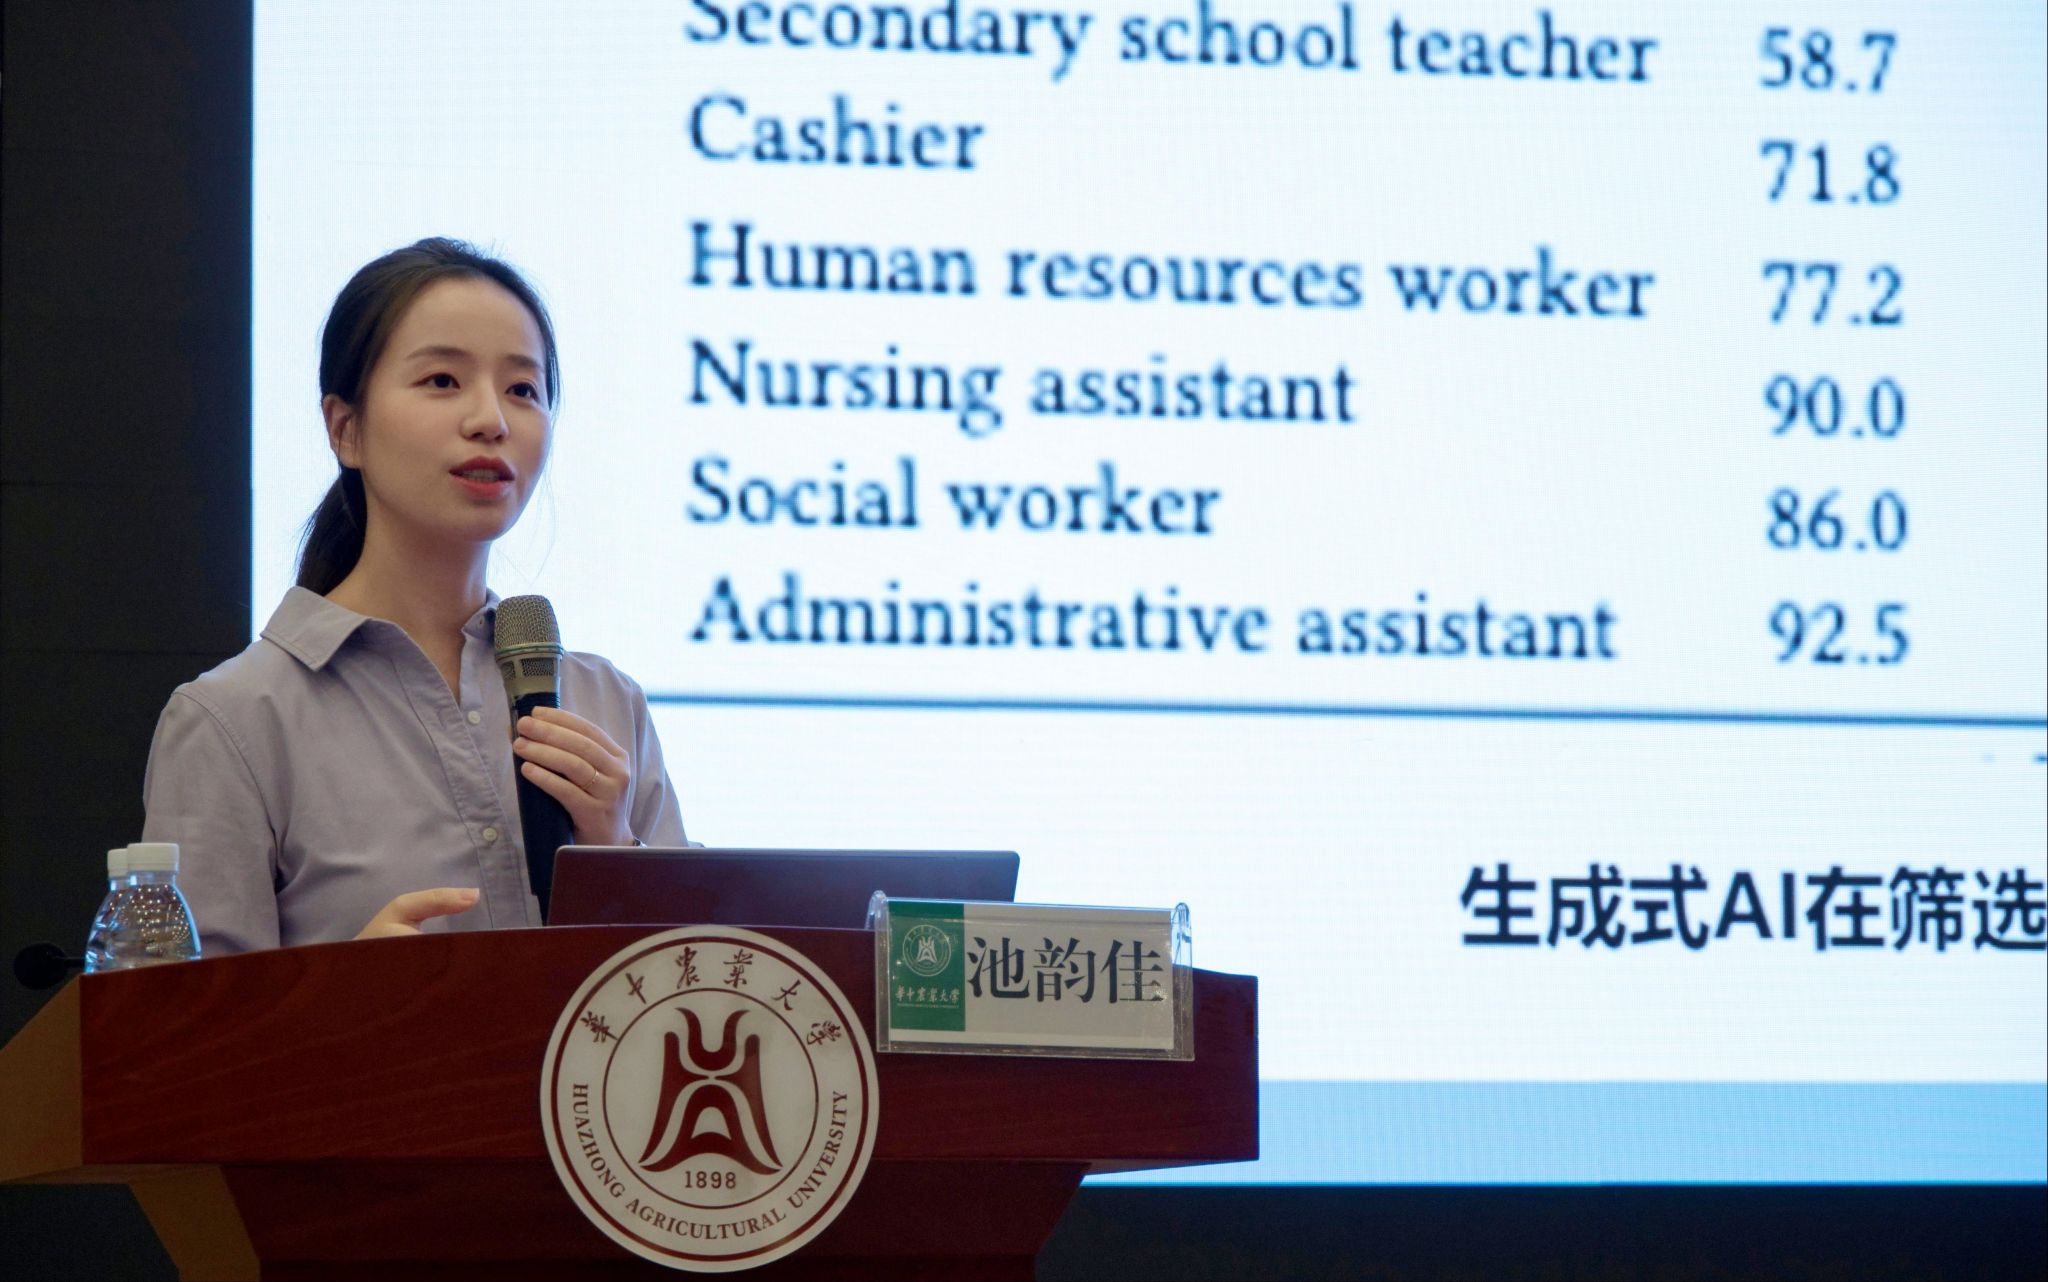
▲池韵佳教授作分享(通讯员 魏婕 摄)
“大家平时会用生成式AI完成哪些任务?”池韵佳老师提出一个问题引发大家思考。“检索信息、获取建议、辅助写作……”同学们踊跃回答。池韵佳老师谈到,生成式AI深度融入同学们的学习生活,但其输出并非全然客观中立。训练数据、算法规则、人机提示交互等各环节都暗藏偏差风险,会潜移默化影响使用者的认知判断与行为决策。
池韵佳老师将生成式AI的偏差来源归纳为数据、算法和交互三大类。她谈到,公开数据往往只覆盖愿意主动表达的群体,大量沉默群体的声音难以进入训练数据集。不同大模型训练语料的语言分布显著失衡,英语语料占比远高于其实际使用者占比,导致模型认知世界的视角存在先天局限。
池韵佳老师介绍,团队通过“蛋挞实验”,实景观察拥挤环境下受试者是否出现多拿蛋挞的不道德行为,并利用生成式AI批量构建虚拟受试人群,复现同一消费行为实验。对照数据显示,AI生成数据的行为效应量显著高于人类真实实验数据,即生成式人工智能更容易放大极端行为结果。
除数据偏差外,算法本身也存在局限。池韵佳老师介绍,大模型本质上习得的是数据间的联合分布概率,而非真正理解现实世界的空间结构、时间逻辑和因果关联。在人机交互环节,同样会催生身份类交互偏差。AI会根据姓名、邮箱、身份标签等,主观推断使用者的种族、性别、教育背景,进而在商品推荐、薪资建议等输出内容中夹带隐形偏见。
面对偏差,如何实现科学有效的治理?池韵佳老师提出,一是补齐垂直私域知识库,校准优化源头训练数据,改善数据偏差。二是强化因果推理与规则约束,完善数据标记体系,弥补算法局限。三是兼顾用户与内容公平,减少交互过程衍生的身份偏见。
交流环节,同学们围绕信息茧房、AIGC甄别方法等踊跃提问,池韵佳老师逐一细致解答。她勉励在场同学,在拥抱人工智能技术红利的同时,要保持清醒头脑,坚持独立思考,敢于追问、主动核验,做到“善驭技而不困于技”。



 最近新闻